非官方資料整理 · 非政府機關/非登記法人組織內容查核 2026-11-16 關於本站
具身智慧進階 · 約 3 分鐘閱讀

ACT 與 Diffusion Policy:兩種動作序列學習思路

理解 action chunk 與擴散式動作生成,再依控制頻率、資料與算力做比較。

文章目錄與閱讀工具
  1. 兩個方法關心的問題
  2. 比較要固定觀測與評測
  3. 先建立簡單而誠實的 baseline
  4. 來源與查核範圍
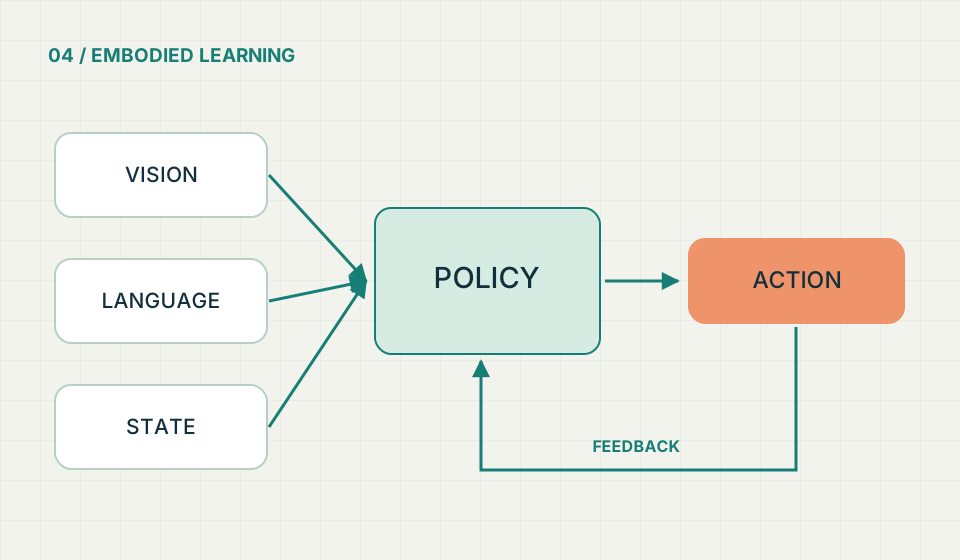
一般視覺/語言/狀態到動作的回饋流程,不代表特定模型內部架構。
TAIRDF 原創示意圖|一般視覺/語言/狀態到動作的回饋流程,不代表特定模型內部架構。不是官方圖、產品照片或實測結果。

先掌握這三件事

  • ACT 以動作區塊減少長任務的逐步決策負擔。
  • Diffusion Policy 以條件擴散方式產生動作序列。
  • 不同論文的成功率不能直接排成跨任務排行榜。

兩個方法關心的問題

研究摘要

ACT 研究以 action chunking 生成一段動作;Diffusion Policy 研究以條件擴散建模動作分布,配合 receding-horizon 執行。這裡只整理方法方向,不重製原論文架構圖或照搬評測結果。[1][2]

比較要固定觀測與評測

工程整理 · 下列實作建議為本站獨立整理,非來源的認證結論

本站建議使用相同任務、感測視角、示範集合與成功標準,記錄訓練成本、推論延遲與控制頻率。資料量不足時,先提高示範一致性,不急著增加模型大小。

動作區塊較長,可能減少決策負擔,但也需要處理新觀測、突發障礙與取消。把「規劃了多少步」和「一次實際執行多少步」分開設計。

先建立簡單而誠實的 baseline

工程整理 · 下列實作建議為本站獨立整理,非來源的認證結論

先用小任務驗證資料收集、訓練、推論與紀錄流程;將失敗拆成看錯、抓錯、軌跡偏離、時間超限與接觸問題。

只發布代表性影片容易掩蓋不穩定。完整紀錄所有試次與人工介入,才能判斷模型是否值得進一步實機整合。

來源與查核範圍

以下為本篇使用的一手來源。本文是獨立重寫與工程導讀,不是全文翻譯。來源宣稱的研究/產品表現,不代表本站已實測;版本頁可能持續更新。

  1. ALOHA / Action Chunking with Transformers(另開視窗)ALOHA / ACT 研究團隊 · 研究專案 · 查核 2026-11-16https://tonyzhaozh.github.io/aloha/
  2. Diffusion Policy(另開視窗)Diffusion Policy 研究團隊 · 研究專案 · 查核 2026-11-16https://diffusion-policy.cs.columbia.edu/

文章中的工程建議與概念圖,均為本站的說明方式,不能當成官方背書、功能安全認證、完整相容性保證或個別法律意見。

發現內容過時或有權利疑慮?回報這篇文章

搜尋技術知識

搜尋只在你的瀏覽器執行,不會送到外部服務。

瀏覽全部文章