
研究的核心定位
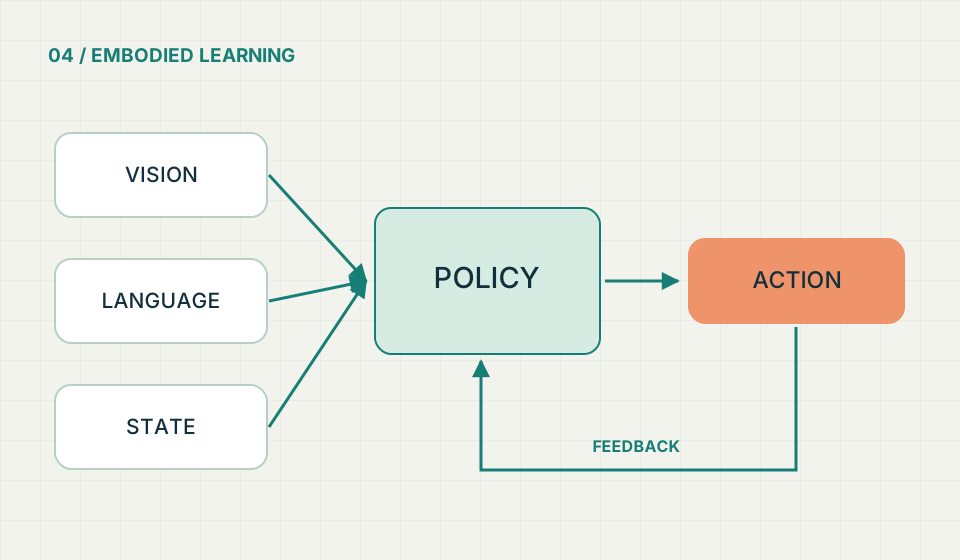
研究摘要OpenVLA 專案介紹將視覺與語言輸入映射為機器人動作,並提供模型與訓練管線資訊。其研究和展示有特定平台、資料與評測條件,不能解讀為任意手臂接上就會工作。[1]
先接好資料契約
工程整理 · 下列實作建議為本站獨立整理,非來源的認證結論本站建議從一份 episode 檢查相機順序、影像處理、機器人狀態、語言指令與動作單位。關節位置、末端位姿與增量控制是不同動作定義,不能只因維度相同就替換。
載入模型後先離線觀察輸出,檢查分布、飽和與不合理跳變,再在模擬或受限環境做閉環測試。
微調後如何證明有改善
工程整理 · 下列實作建議為本站獨立整理,非來源的認證結論保留不同場景、物件與示範來源的測試集,避免相鄰影格跨到訓練與測試造成過度樂觀。固定成功條件、測試次數與人工介入規則。
模型、基礎模型、資料與機器人資產可能有不同授權。使用「開源」一詞之前,逐項檢查程式、權重和資料權利,不把研究可取得等同無條件商用。